· Soft.immo · Réflexions · 10 min read
Spec-driven development : la spec n'est pas un livrable, c'est le code source
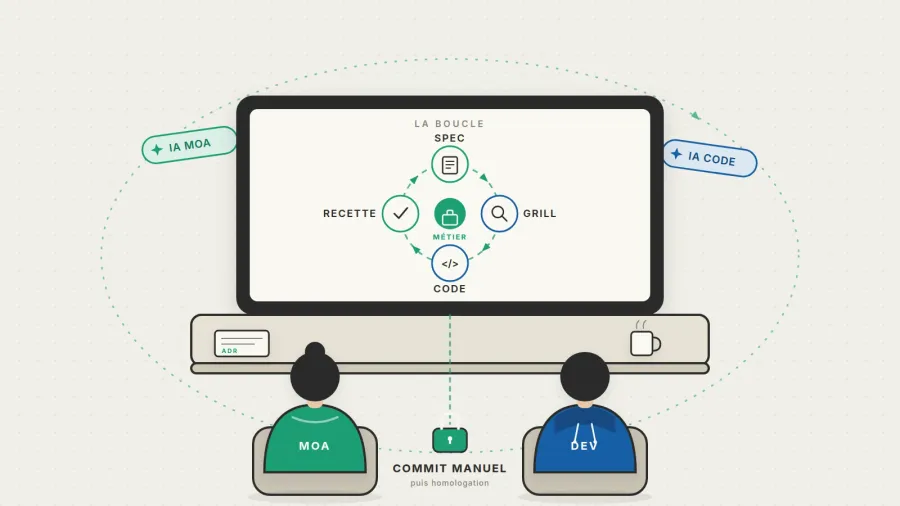
Glossaire, ADR, specs, tickets, reviews : la chaîne que j'utilise pour faire coder des agents IA sans perdre le fil — et sans leur céder Git.
Dans l’article précédent, je disais que l’IA ne remplace pas les devs : elle rend les mauvaises specs encore plus dangereuses.
Il me manquait la moitié de l’histoire. Comment on empêche une spec de pourrir ?
Parce qu’un PRD rédigé en début de projet ne survit pas à trois semaines de développement. À la fin, il ne reste que le code — et plus personne pour se souvenir pourquoi il est comme ça.
Le Spec-driven development (SDD) ne répond pas à ça en écrivant un meilleur document de cadrage. Il change la nature de la spec : elle cesse d’être un livrable de réunion pour devenir un artefact du dépôt, versionné avec le code, lu par les humains et par les agents.
Le PRD est un moment. La spec est un artefact.
| PRD classique | Spec dans le dépôt | |
|---|---|---|
| Où il vit | Notion, Confluence, la boîte mail | docs/spec/, à côté du code |
| Durée de vie | Jusqu’au kickoff | Aussi longtemps que le code |
| Qui le lit | Les humains, une fois | Les humains et les agents, à chaque session |
| Quand il change | Rarement, et sans diff | Dans la même MR que le code |
La différence n’est pas de forme, elle est de nature. Un PRD répond à « qu’est-ce qu’on veut ? » une fois. Une spec dans le dépôt répond à « qu’est-ce qu’on veut ? » à chaque fois qu’un agent ouvre le projet.
👉 Ce qui change : on ne demande plus à l’IA de deviner le contexte. On lui donne un endroit où le lire.
1. Griller l’idée avant d’écrire une ligne
Mon point d’entrée, c’est grill-with-docs, un skill de Matt Pocock. Sa description tient en une phrase : « a relentless interview to sharpen a plan, which also creates docs (ADR’s and glossary) as we go ».
Concrètement, il compose deux skills :
grilling— un arbre de décisions exploré par rounds. À chaque round, toutes les questions dont les prérequis sont déjà tranchés, numérotées, avec une réponse recommandée. On ne passe au round suivant qu’une fois les précédentes réglées.domain-modeling— la discipline qui consiste à contester le vocabulaire. Dès qu’un terme est flou ou entre en conflit avec le glossaire, on le tranche, et on l’écrit tout de suite.
Le point contre-intuitif : l’interview produit la documentation en passant. On ne « rédige pas la doc à la fin ». Chaque réponse tranchée devient soit un terme du glossaire, soit une décision d’architecture. Si une question ne produit ni l’un ni l’autre, c’était probablement une question sans enjeu.
Exemple réel, sur Vetflow. Trois mots qui se ressemblent :
Référent — vétérinaire ou clinique qui prescrit et envoie l’examen. Avoid: client, prescripteur seul
Assistant — personne autorisée par la clinique à réaliser la demande à la place du référent.
Radiologue — spécialiste qui interprète l’examen. Avoid: spécialiste hors synonymie avec Radiologue
Sans ces trois lignes, un agent écrit client à un endroit, user à un autre, et produit trois mois plus tard un écran qui parle à la mauvaise personne. Le bug n’est pas dans le code : il est dans le mot.
2. Graver le vocabulaire : GLOSSARY.md
Le glossaire n’est pas un lexique décoratif. C’est la spec de nommage du projet.
Chez moi, chaque entrée suit le même gabarit : le terme canonique, une définition courte, et surtout une ligne _Avoid_ qui liste les synonymes interdits. C’est cette dernière qui fait le travail : elle dit à l’agent ce qu’il ne doit pas écrire.
Ordres de grandeur, pour situer : 146 lignes pour Vetflow, 267 pour pat’immo. Ce n’est pas un roman. C’est un vocabulaire borné, qui tient dans une fenêtre de contexte et qui se relit vite.
Et quand le code utilise un mot absent du glossaire, ça veut dire une de deux choses : soit l’agent invente du langage que le projet n’utilise pas, soit il y a un vrai trou — et ce trou mérite d’être comblé.
3. Graver les décisions techniques : les ADR
Le glossaire fixe les mots. Les ADR — Architecture Decision Records — fixent les choix techniques.
La définition de référence est celle de Michael Nygard, qui a nommé le concept en 2011. Un ADR y est décrit comme un fichier texte court qui expose « a set of forces and a single decision in response to those forces » — un ensemble de forces en présence, et une seule décision en réponse à ces forces.
Ce qui rend une décision « architecturale » n’a rien de mystérieux. Nygard vise celles qui touchent la structure, les caractéristiques non fonctionnelles, les dépendances, les interfaces ou les techniques de construction. Autrement dit : ce qui coûte cher à changer six mois plus tard. Un choix de base de données, de découpage en modules, de stratégie de cache, de format d’échange. Pas la couleur d’un bouton.
Martin Fowler ajoute la règle qui sépare une mémoire d’un roman : un ADR accepté ne se réécrit jamais. Si la décision change, on le marque superseded et on lie le suivant. L’historique reste un historique, pas une version corrigée du passé.
Un ADR tient en une à deux pages : un titre qui énonce la décision, puis quatre sections :
| Section | Contenu |
|---|---|
| Statut | proposed, accepted, superseded |
| Contexte | les faits, les contraintes, les forces en tension |
| Décision | « nous ferons… », à la voix active |
| Conséquences | ce qui change ensuite, y compris ce que ça coûte |
Un ADR ne dit pas comment implémenter. Il dit pourquoi on a pris cette voie, et ce qu’on accepte de perdre en échange.
Chez Vetflow, ils vivent dans docs/adr/, numérotés, avec ce format exact. Une soixantaine de décisions y sont tracées aujourd’hui.
Un exemple qui parle de lui-même, l’ADR-0028 : relecture automatique des merge requests par IA (OpenCode + Mistral). Statut « à discuter », principes non négociables noir sur blanc — ne jamais bloquer la MR, diff uniquement, agent en lecture seule, revue humaine maintenue.
Voilà ce qu’un ADR apporte à un agent : il ne peut plus proposer l’inverse sans le voir. Et s’il le propose quand même, la review le signale comme un conflit, pas comme une opinion.
La règle que je me suis fixée : l’ADR s’écrit au moment où la décision se prend, pas après pour la justifier. Un ADR rétro-justificatif est pire que pas d’ADR du tout — il fabrique une fausse mémoire, et un agent qui lit une fausse mémoire prend de fausses décisions avec beaucoup d’assurance.
4. Donner le mode d’emploi aux agents
Un dépôt qui contient un glossaire et des ADR reste muet si l’agent ne sait pas où regarder ni comment travailler.
D’où AGENTS.md. Le mien fait 46 lignes. Il ne contient pas tout : il contient l’index.
- les commandes qui comptent (
make qa-fast,make tests,make db-desc) - les pointeurs vers le domaine (
GLOSSARY.md,docs/adr/) - les conventions non négociables (Conventional Commits, prompts externalisés, Tailwind + Twig Components)
- et une section « détails (charger à la demande) »
Cette dernière section est la plus importante. Elle envoie vers docs/agents/ : qa.md, db.md, testing.md, architecture.md, gotchas.md, issue-tracker.md, domain.md, triage-labels.md — et, côté pat’immo, un skills.md qui route chaque type de tâche vers le bon skill. Chargés seulement quand la tâche les concerne.
🎯 Un AGENTS.md court n’est pas une doc incomplète. C’est un index. Le contexte est une ressource rare : chaque ligne payée à chaque prompt doit mériter sa place.
5. De la spec aux tickets, puis au code
Une spec qui reste un document isolé ne produit rien. Il faut la découper en travail exécutable.
C’est le rôle de la chaîne de Matt Pocock :
to-spec— synthétise la conversation en spec, sans ré-interviewer. Le débat a déjà eu lieu pendant le grill.to-tickets— découpe en tranches verticales (« tracer bullets »), chacune déclarant les tickets qui la bloquent.implement-spec— implémente l’ensemble sur une branche d’intégration, ticket par ticket.
Et en dessous, il y a l’autre couche : obra/superpowers. Moins orientée « produit », plus orientée processus — brainstorming → writing-plans → executing-plans (TDD, commits incrémentaux) → verification-before-completion. Avec, au passage, using-git-worktrees, subagent-driven-development et requesting-code-review.
C’est là que les deux approches s’emboîtent vraiment :
| Couche | Rôle | Exemples |
|---|---|---|
| Produit / doc | Griller, écrire la spec, la découper | grill-with-docs, to-spec, to-tickets, code-review |
| Processus | Planifier, exécuter, vérifier | brainstorming, writing-plans, executing-plans, verification-before-completion |
| Domaine | Conventions et gestes du métier | superpowers-symfony, bbz-* |
La troisième couche est celle qui rend le tout utilisable au quotidien : symfony-voters pour une habilitation, doctrine-migrations pour un schéma, functional-tests pour verrouiller un contrôleur. Et un fichier docs/agents/skills.md qui fait le routage : « pour un voter → symfony-voters + functional-tests ».
Un skill n’est pas un prompt magique. C’est une procédure revue, versionnée, avec un point de sortie.
6. Relire contre la spec, pas contre son goût
C’est le maillon que la plupart des équipes sautent. Et c’est celui qui rend le SDD rentable.
code-review relit le diff depuis un point fixe (git diff <ref>...HEAD) sur deux axes, confiés à deux sous-agents qui ne partagent pas leur contexte :
- Standards — le code respecte-t-il les conventions documentées du dépôt ? (plus une base de code smells de Fowler, que le dépôt peut surcharger)
- Spec — le diff implémente-t-il réellement ce que la spec et les tickets demandaient ?
👉 Une review sans spec juge des goûts. Une review avec spec juge des écarts.
Deux sous-agents, c’est aussi une décision de conception : si le même agent juge les deux axes, il rationalise. Séparés, ils se contredisent — et c’est exactement ce qu’on veut voir.
Pour Symfony, j’utilise une variante maison, bbz-symfony-mr-review : même intention, mais qui corrige — bloquants, majeurs, quick wins, purge du code mort, puis gate QA (make qa-fast, make qa-check). En CI GitLab, le même skill tourne en lecture seule et poste un commentaire, sans jamais toucher au code.
C’est l’ADR-0028, et c’est un choix de doctrine : la relecture IA est indicative, jamais bloquante. Elle accélère la review humaine. Elle ne la remplace pas.
7. Je garde la main sur Git
C’est le point où je me sépare du « vibe coding » spectaculaire.
Un agent peut écrire 800 lignes. Ce n’est pas lui qui signe le commit.
- les commits sont en Conventional Commits, vérifiés par un hook
commit-msg - un agent ne pousse rien tout seul : il propose, je relis, je commite
- une review IA ne bloque pas une MR — c’est un signal, pas un portier
- une modification de spec, ou un nouvel ADR qui remplace l’ancien, passe dans la même MR que le code qu’il justifie
La spec ne sert pas à aller plus vite en sautant la relecture. Elle sert à ce que la relecture ait un référentiel, et à ce que la décision survive à la session.
🎯 L’IA propose. L’humain décide. Le dépôt se souvient.
Ce que ça coûte
Je ne vends pas la méthode comme gratuite.
- Le grill prend du temps. Comptez 30 à 60 minutes de questions avant la première ligne de code sur un sujet non trivial. C’est du temps que vous auriez passé à déboguer plus tard, mais il faut accepter de le payer d’avance.
- Un glossaire non maintenu pourrit. Un terme obsolète est plus dangereux qu’un terme absent : l’agent le lit et l’applique avec confiance.
- L’ADR rétro-justificatif est un anti-pattern. Si vous écrivez la décision après coup pour valider ce qui a été fait, vous documentez votre biais, pas votre raisonnement.
- Trop de doc tue la doc. Quinze fichiers
docs/agents/que personne ne lit, c’est quinze fichiers qui coûtent du contexte et n’apportent rien.
Et il y a des cas où il ne faut pas le faire : un script jetable, un spike, un prototype qu’on va jeter. Le SDD est un investissement de mémoire. Sur du code qui ne vivra pas, il n’y a rien à mémoriser.
Conclusion
Le code est devenu une commodité. Ce qui ne l’est pas :
- le vocabulaire — parce qu’un mot mal défini produit un système mal aligné
- les décisions — parce qu’une décision non écrite sera reprise trois fois
- le contrôle — parce qu’un diff que personne n’a relu n’est pas un livrable, c’est un pari
Le SDD n’est pas une méthodologie de plus. C’est la réponse à une question très concrète : si demain un agent reprenait ce dépôt sans moi, que lirait-il ?
Si la réponse est « les commit messages », il manque l’essentiel.
💬 Combien de décisions de votre projet existent encore uniquement dans la tête de quelqu’un ? Et si votre meilleur développeur partait demain, que resterait-il de son raisonnement dans le dépôt ?